
要解决的问题
语音智能体的表现不只取决于用户说了什么,还取决于声音听起来如何、何时开口。固定脚本式的评测只给出一个任务,不再有后续交互,许多对话行为就测不到。人工测试更接近真实,但成本高,不同测试者和不同场次之间也难以稳定对比。Foundry 的语音用户模拟器就是针对这个缺口:由模拟器扮演用户,与被测的语音智能体进行口头对话。
三个可独立配置的维度
第一是场景。开发者描述用户想完成什么,并提供相关事实与约束,而不是逐句写台词。模拟器根据已有对话逐轮生成用户发言。按文章说法,它会保持所给事实一致,且不会替智能体设计流程。
第二是声学条件。可以选择不同的声音,并叠加环境噪声,例如街道、人群、背景电视、地铁站,也可以加上电话式的窄带音频处理。具体可选项取决于服务与项目配置。
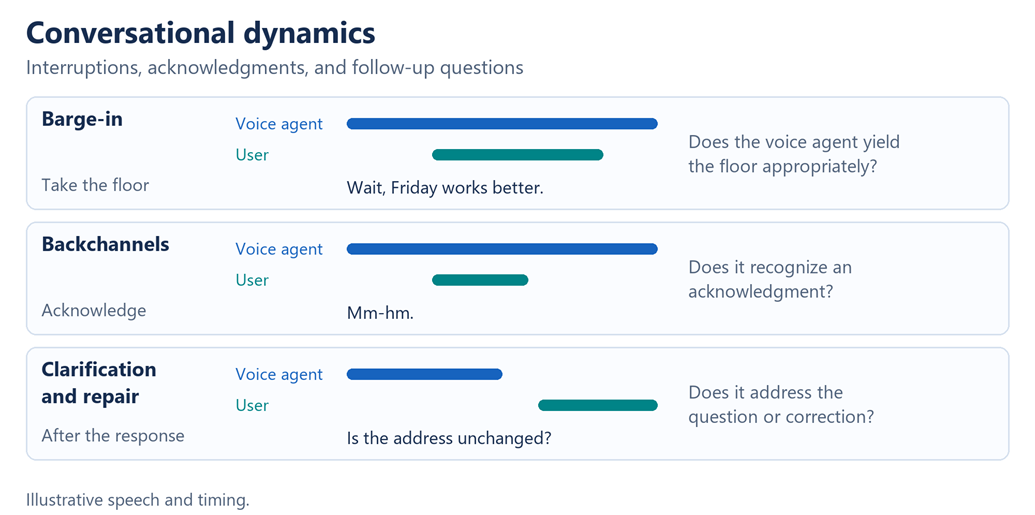
第三是对话动态,属于可选预设,包括三类行为:打断(barge-in)、简短附和(backchannel),以及在较长回复中插入澄清或纠正。文章强调,目的是还原日常交流,而不是单纯增加难度。
我的分析
这套设计的价值在于把“说什么”“听起来怎样”“怎么插话”拆开,可以单独变化,也可以组合。这样当某项配置改动后,团队能在同一设置下比较结果,定位退化来自哪个因素。例如,同一个改期请求在安静环境和嘈杂电话中表现不同,就能分别暴露识别和打断处理上的问题。
适用场景主要是客服、订单查询、预约等任务型语音应用的上线前回归测试。对开发者而言,它可以减少人工打电话的工作量,并让测试可重复。文章提到有 SDK 和 REST API 示例,可以融入现有流程,但具体集成方式需要查阅官方指南。
值得继续观察的问题
- 文章中的图和对话均为示意,没有给出实测数据,模拟结果与真实用户行为的贴近程度尚无公开证据。
- 模拟用户本身由模型生成,其稳定性和对评测结论的影响,我推测需要团队自行验证。
- 可用声音、口音和环境音依赖服务可用性,覆盖面是否满足特定语言和地区,需要实际确认。
来源
原文见 Microsoft Foundry Blog:https://techcommunity.microsoft.com/blog/azure-ai-foundry-blog/beyond-the-script-evaluating-voice-agents-with-voice-user-simulator/4559696


- 作者:月明
- 链接:https://lunalight.top//article/azure-foundry-4559696
- 声明:本文采用 CC BY-NC-SA 4.0 许可协议,转载请注明出处。


